Ubuntu 24.04 + NVIDIA L40 部署 Qwen3.8-27B-FP8 私有化推理实战(vLLM + Open-WebUI)

本文记录在单卡 L40(48GB)上,使用 vLLM 将阿里开源的 Qwen3.8-27B-FP8 部署为 OpenAI 兼容 API,并接入 Open-WebUI 的完整流程,涵盖驱动 / CUDA、Python 环境、模型下载、服务启动参数详解与常见排错。全部命令基于实测环境整理,可直接落地。

一、模型与环境说明

Qwen3.8-27B-FP8 是 Qwen3.8 系列的 270 亿参数稠密模型,采用 Apache 2.0 协议开源。与部署强相关的几个特性决定了后面的启动参数:

  • 多模态:内置视觉塔(vision tower),支持图文输入,因此需要 --mm-encoder-tp-mode data
  • 混合注意力:64 层中仅 16 层为全注意力,其余 48 层为线性注意力,恒定循环状态使 KV Cache 占用远低于同规模全注意力模型,对单卡长上下文非常友好。
  • 默认思考模式:推理时默认输出 <think>...</think> 思考内容,因此需要 --reasoning-parser qwen3 进行解析。
  • 原生 262K 上下文,可经 YaRN 扩展至 1M;内置 MTP 草稿头,可开启投机解码降低时延。
  • FP8 量化:官方 Qwen/Qwen3.8-27B-FP8 为 block-size 128 的细粒度 FP8,精度接近原始 BF16 权重,L40(Ada 架构 sm_89)原生支持 FP8 计算。

显存规划

27B 级稠密模型在不同精度下的权重显存(不含 KV Cache)大致如下:

精度 权重显存 单卡 L40(48GB)
BF16 约 56GB 单卡放不下,需 2 卡
FP8 约 28GB  单卡可跑,余量约 16GB 供 KV Cache
4-bit 约 14–16GB 单卡宽裕

结论L40 单卡跑 FP8 权重约 28GB,配合混合注意力带来的低 KV Cache 开销,--max-model-len 32768 下显存非常宽松,实际还可以把上下文往上调。

二、系统准备与 NVIDIA 驱动

sudo apt update && sudo apt upgrade -y
sudo apt install -y alsa-utils

# 查看可用驱动,选择 server 版
ubuntu-drivers list
sudo apt install -y nvidia-driver-595-server
sudo reboot        # 驱动装完务必重启

# 重启后确认驱动就绪
nvidia-smi

注意:避免驱动重复安装下一步安装的 CUDA 本地 .deb 仓库已经打包了 595.45.04 驱动。若你打算用 CUDA 本地包安装驱动,这里可以跳过 nvidia-driver-595-server,避免两套驱动来源冲突。二选一即可,装完统一重启一次。

三、安装 CUDA Toolkit 13.2

# 固定仓库优先级
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-ubuntu2404.pin
sudo mv cuda-ubuntu2404.pin /etc/apt/preferences.d/cuda-repository-pin-600

# 本地仓库包(内含 595.45.04 驱动)
wget https://developer.download.nvidia.com/compute/cuda/13.2.0/local_installers/cuda-repo-ubuntu2404-13-2-local_13.2.0-595.45.04-1_amd64.deb
sudo dpkg -i cuda-repo-ubuntu2404-13-2-local_13.2.0-595.45.04-1_amd64.deb
sudo cp /var/cuda-repo-ubuntu2404-13-2-local/cuda-*-keyring.gpg /usr/share/keyrings/
sudo apt-get update
sudo apt-get -y install cuda-toolkit-13-2

配置环境变量(解决 nvcc not found)

若执行 nvcc --version 提示 Command 'nvcc' not found,说明 CUDA 的 bin 目录未加入 PATH。编辑 ~/.bashrc,追加:

export PATH=/usr/local/cuda-13.2/bin${PATH:+:${PATH}}
export LD_LIBRARY_PATH=/usr/local/cuda-13.2/lib64${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}
source ~/.bashrc
nvcc --version

正常输出应类似:

nvcc: NVIDIA (R) Cuda compiler driver
Cuda compilation tools, release 13.2, V13.2.51
Build cuda_13.2.r13.2/compiler.37434383_0

四、创建 Python venv 环境

坚持使用独立虚拟环境隔离依赖,不使用 --break-system-packages 污染系统 Python:

sudo apt install -y python3.12-venv python3-pip
python3 -m venv ~/venvs/qwen3
source ~/venvs/qwen3/bin/activate
pip install -U pip setuptools wheel

五、安装 vLLM

版本要求Qwen3.8 系列为新架构,需较新的 vLLM 才能正确加载。若正式版尚未跟进,请使用 nightly 预发布版本。装完用 vllm --version 确认。

# 优先尝试正式版
pip install -U vllm

# 如加载失败 / 报架构不识别,改用 nightly
pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly

# 下载工具
pip install -U modelscope huggingface_hub

六、下载模型(ModelScope)

国内环境推荐从 ModelScope 拉取,速度更稳定:

mkdir -p /data/models
modelscope download --model Qwen/Qwen3.8-27B-FP8 \
  --local_dir /data/models/Qwen3.8-27B-FP8

七、启动 vLLM 推理服务

vllm serve /data/models/Qwen3.8-27B-FP8 \
  --tensor-parallel-size 1 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder \
  --reasoning-parser qwen3 \
  --mm-encoder-tp-mode data \
  --trust-remote-code \
  --served-model-name Qwen3.8-27B \
  --max-num-seqs 16 \
  --max-model-len 32768 \
  --enable-prefix-caching \
  --gpu-memory-utilization 0.92

关键参数说明

参数 作用
--tensor-parallel-size 1 单卡 L40,张量并行度为 1。
--enable-auto-tool-choice + --tool-call-parser qwen3_coder 启用函数调用(Function Calling),使用 Qwen3 Coder 工具调用解析器,供智能体使用。
--reasoning-parser qwen3 解析模型默认输出的 <think> 思考内容。
--mm-encoder-tp-mode data 多模态视觉编码器采用数据并行模式(该模型带视觉塔)。
--enable-prefix-caching 前缀缓存,重复上下文场景显著提升吞吐(官方 recipe 推荐)。
--max-model-len 32768 单卡下的稳妥上下文长度;显存有余量时可上调(模型原生支持 262K)。
--gpu-memory-utilization 0.92 显存利用率上限,48GB 下预留系统余量。

进阶:开启 MTP 投机解码(可选)该模型内置 MTP 草稿头,追加以下参数可降低解码时延:

--speculative-config '{"method":"mtp","num_speculative_tokens":1}'

优化后的参数

vllm serve /data/models/Qwen3.8-27B-FP8 \
--tensor-parallel-size 1 \
--served-model-name Qwen3.8-27B \
--trust-remote-code \
--max-model-len 131072 \
--speculative-config '{"method":"mtp","num_speculative_tokens":3}' \
--kv-cache-dtype fp8 \
--enable-prefix-caching \
--enable-chunked-prefill \
--max-num-batched-tokens 8192 \
--max-num-seqs 2 \
--gpu-memory-utilization 0.90 \
--mm-encoder-tp-mode data \
--limit-mm-per-prompt '{"image": 4, "video": 0}' \
--mm-processor-kwargs '{"min_pixels": 3136, "max_pixels": 1003520}' \
--mm-processor-cache-gb 2 \
--enable-auto-tool-choice \
--tool-call-parser qwen3_xml \
--reasoning-parser qwen3

1. --speculative-config MTP 投机解码(最主要,通常 1.7–2.5×)
这是唯一一个直接改变解码算法的参数。原理:

普通解码:每次前向只出 1 个 token,且 decode 阶段是显存带宽瓶颈(要把 27B 的全部权重从 HBM 搬一遍才吐一个 token),GPU 算力利用率往往只有个位数百分比。
MTP(Multi-Token Prediction):模型自带的轻量 draft head 一次猜出后面 3 个 token,然后用一次前向并行验证这 4 个。接受率通常 60%–75%,等于一次权重搬运产出 2–3 个 token。

所以提升的不是算力,而是把「浪费掉的算力」换成了 token。它在小 batch 下收益最大,而你恰好把 max-num-seqs 调成了 2 —— 两者是叠加放大的。

2. --max-num-seqs 16 → 2(对"单请求 tok/s"影响巨大)
这条要看你测的是哪个指标:

指标 16 seqs 2 seqs
单请求速度(tok/s per request) 低 高很多
整机总吞吐(并发满载时) 高 低

batch 越大,每个 token 的显存带宽被更多请求摊薄,单请求就越慢。你调到 2,等于把整块卡的带宽让给 1–2 个请求。如果你是在网页/单会话里体感测速,这一条能贡献很大一部分观感提升。

同时 max-num-seqs 小也让 MTP 的接受收益不被大 batch 稀释(大 batch 下投机解码经常反而变慢,因为验证阶段变成算力瓶颈)。

3. --kv-cache-dtype fp8(两重收益)
容量:KV cache 从 FP16 变 FP8,每 token 显存减半。这是你能把 max-model-len 从 32768 拉到 131072 还不 OOM 的前提。
速度:长上下文下 attention 要扫描全部 KV,读取量减半 → attention kernel 明显加速。上下文越长,这条收益越大。
4. 旧配置很可能在发生 preemption(抢占重算)

旧配置 max-num-seqs 16 + max-model-len 32768 + FP16 KV。27B FP8 权重约 27 GB,剩余 KV 空间有限。一旦并发请求的上下文变长,vLLM 会 preempt(抢占) 部分序列,把它们的 KV 丢弃、之后重新 prefill 一遍。日志里会出现 Sequence group ... is preempted。

这是隐形的性能杀手,重算是纯浪费。新配置 fp8 KV + 只 2 条序列,KV 池极其宽裕,基本不会抢占。

5. --enable-chunked-prefill + --max-num-batched-tokens 8192
把长 prompt 的 prefill 切成 8192 token 的块,与 decode 混合调度。效果是 prefill 不再长时间独占 GPU 阻塞正在解码的请求,token 输出变得平滑、不卡顿。对"体感速度"有帮助,对纯单请求吞吐影响不大。

(注:vLLM V1 引擎里 chunked prefill 默认已开启,显式写上只是明确化。)

6. --mm-processor-cache-gb 2
多模态预处理缓存。同一张图在多轮对话里反复出现时,不再重复跑 ViT 预处理/编码,省掉可观的 TTFT。

逐行详解
vllm serve /data/models/Qwen3.8-27B-FP8
启动 OpenAI 兼容 API 服务,加载本地权重目录。FP8 权重本身要求 Hopper/Ada(H100/H800/L40S/L20,SM≥89)才有原生加速,Ampere 上会走模拟路径而变慢。

--tensor-parallel-size 1
张量并行度 1 = 单卡跑完整模型,不做层内切分。27B FP8 约 27–28 GB 权重,单卡 48/80 GB 放得下。

--served-model-name Qwen3.8-27B
对外暴露的模型名。客户端 "model": "Qwen3.8-27B" 即可,不必写完整路径。

--trust-remote-code
允许执行模型仓库里自带的 Python 建模代码(modeling_*.py、processing_*.py)。多模态/新架构模型通常必需。只对可信来源的权重开启。

--max-model-len 131072
单请求上下文上限(prompt + 输出)128K。这个值直接决定 vLLM 预留的最大 KV 规模和 RoPE 配置,能开到 128K 靠的是 fp8 KV。

--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
启用 MTP 投机解码,每步预测 3 个候选 token。

num_speculative_tokens 调大(如 5)不一定更快:接受率随位置递减,验证成本线性上升,通常 2–4 是甜点。
前提:权重目录里必须含 MTP head 权重,否则启动直接报错。
输出与非投机解码在数值上等价(拒绝采样保证分布一致),不掉质量。

--kv-cache-dtype fp8
KV cache 用 FP8(默认 e4m3)存储。显存减半、attention 读带宽减半。精度影响一般很小,但超长上下文的精确检索类任务(大海捞针、长文档引用)可能有轻微退化。

--enable-prefix-caching
跨请求复用相同前缀的 KV block。对固定 system prompt、多轮对话、RAG 中重复文档块效果显著——命中即跳过该段 prefill,TTFT 大幅下降。新旧配置都开了,不是本次提速的原因。

--enable-chunked-prefill
长 prompt 分块预填充,与 decode 混合调度。见上文第 5 点。

--max-num-batched-tokens 8192
单次调度迭代处理的 token 总数上限(prefill chunk + decode 之和)。

调大 → prefill 更快,但正在解码的请求卡顿更明显。
调小 → 输出更平滑,长 prompt 首 token 变慢。
8192 是长上下文场景比较均衡的取值。

--max-num-seqs 2
并发运行序列数上限。这是延迟/吞吐的核心权衡开关:

2 = 极致低延迟、单请求最快,适合个人使用或对话式场景。
但第 3 个请求到来时会排队等待,多人共用时体验会很差。
如果要服务多人,建议调到 8–16,此时 MTP 收益会缩水,甚至可以考虑关掉投机解码。

--gpu-memory-utilization 0.90
允许 vLLM 占用的显存比例。权重 + 激活 + CUDA graph 之外的部分全部做成 KV pool。从 0.92 降到 0.90 是略微减少 KV,但 fp8 KV 带来的翻倍容量远远抵消了。留 10% 余量对多模态是合理的(ViT 编码器的激活峰值不好预估)。

--mm-encoder-tp-mode data
多模态编码器(ViT)用数据并行而非张量并行切分——多张图分给不同 rank 各自编码。在 TP=1 下此参数实际无效,是为将来多卡准备的。

--limit-mm-per-prompt '{"image": 4, "video": 0}'
单请求最多 4 张图、禁用视频。作用是限制多模态 token 占用上限,防止用户塞几十张图撑爆 KV 导致 OOM。是保护性参数,不影响速度。

--mm-processor-kwargs '{"min_pixels": 3136, "max_pixels": 1003520}'
图像动态分辨率范围。

min_pixels=3136 = 56×56,下限。
max_pixels=1003520 ≈ 1024×980,上限。
直接决定一张图消耗多少 vision token(Qwen 系列约 28×28 像素 → 1 token,再经 2×2 merge)。调低 max_pixels 是加速多图推理最有效的手段,代价是细节/OCR 能力下降。

--mm-processor-cache-gb 2
2 GB 多模态预处理结果缓存,避免重复图片反复跑预处理。

--enable-auto-tool-choice
允许 tool_choice: "auto",由模型自主决定是否调用工具。不开则只能强制指定或禁用。

--tool-call-parser qwen3_xml
把模型输出的工具调用文本解析成 OpenAI 标准的 tool_calls 结构。
这是你另一个实质性改动:qwen3_coder 和 qwen3_xml 的格式不同,必须与模型实际训练的 chat template 匹配。选错的表现是工具调用被当成普通文本吐出来,或解析报错。多模态版 Qwen3 一般用 qwen3_xml。

--reasoning-parser qwen3

... 思考内容从正文剥离,放进响应的 reasoning_content 字段。前端可以折叠显示思维链。

八、部署 Docker + Open-WebUI

# 安装 Docker(阿里云镜像加速)
curl -fsSL https://get.docker.com | sh -s -- --mirror Aliyun
systemctl enable --now docker

# 启动 Open-WebUI,指向 vLLM 的 OpenAI 兼容端点
docker run -itd -p 3000:8080 \
  -e OPENAI_API_BASE_URL=http://10.53.6.222:8000/v1 \
  -e OPENAI_API_KEY=sk-anything \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:main

安全提示OPENAI_API_KEY=sk-anything 仅为占位符(vLLM 默认不校验 Key)。该服务应限定在内网访问;若需对外,请为 vLLM 配置 --api-key 并在网关层做鉴权与限流。

九、验证与访问

服务启动后可通过 curl 快速验证 API:

curl http://10.53.6.222:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen3.8-27B",
    "messages": [{"role":"user","content":"你好,介绍一下你自己"}]
  }'
用途 地址
智能体 / API 直接调用(OpenAI 兼容) http://10.53.6.222:8000/v1
Open-WebUI 网页端 http://10.53.6.222:3000/

十、常见问题排查

现象 原因与处理
nvcc: command not found CUDA bin 未入 PATH,按第三节配置 ~/.bashrcsource
nvidia-smi 无输出 / 驱动异常 驱动未加载或版本冲突。确认只保留一套驱动来源,重启后再试。
vLLM 报模型架构不识别 vLLM 版本过旧,改用 nightly 预发布版。
启动时 CUDA OOM 下调 --gpu-memory-utilization(如 0.85)或 --max-model-len
Open-WebUI 连不上模型 核对 OPENAI_API_BASE_URL 的 IP / 端口,确认 vLLM 已就绪且防火墙放行 8000。
模型下载中断 ModelScope 支持断点续传,重跑 modelscope download 即可。

环境:Ubuntu 24.04 · NVIDIA L40(48GB, Ada sm_89)· CUDA 13.2 / Driver 595.45.04 · vLLM · Qwen3.8-27B-FP8。命令基于实测环境整理,落地前请结合自身网络与安全策略调整内网 IP、端口与鉴权配置。

一个脚本搞定Ubuntu\Rocky登录后自动展示 CPU/内存/多盘使用情况

登录Linux服务器后,自动展示平时关注的系统信息,一目了然。
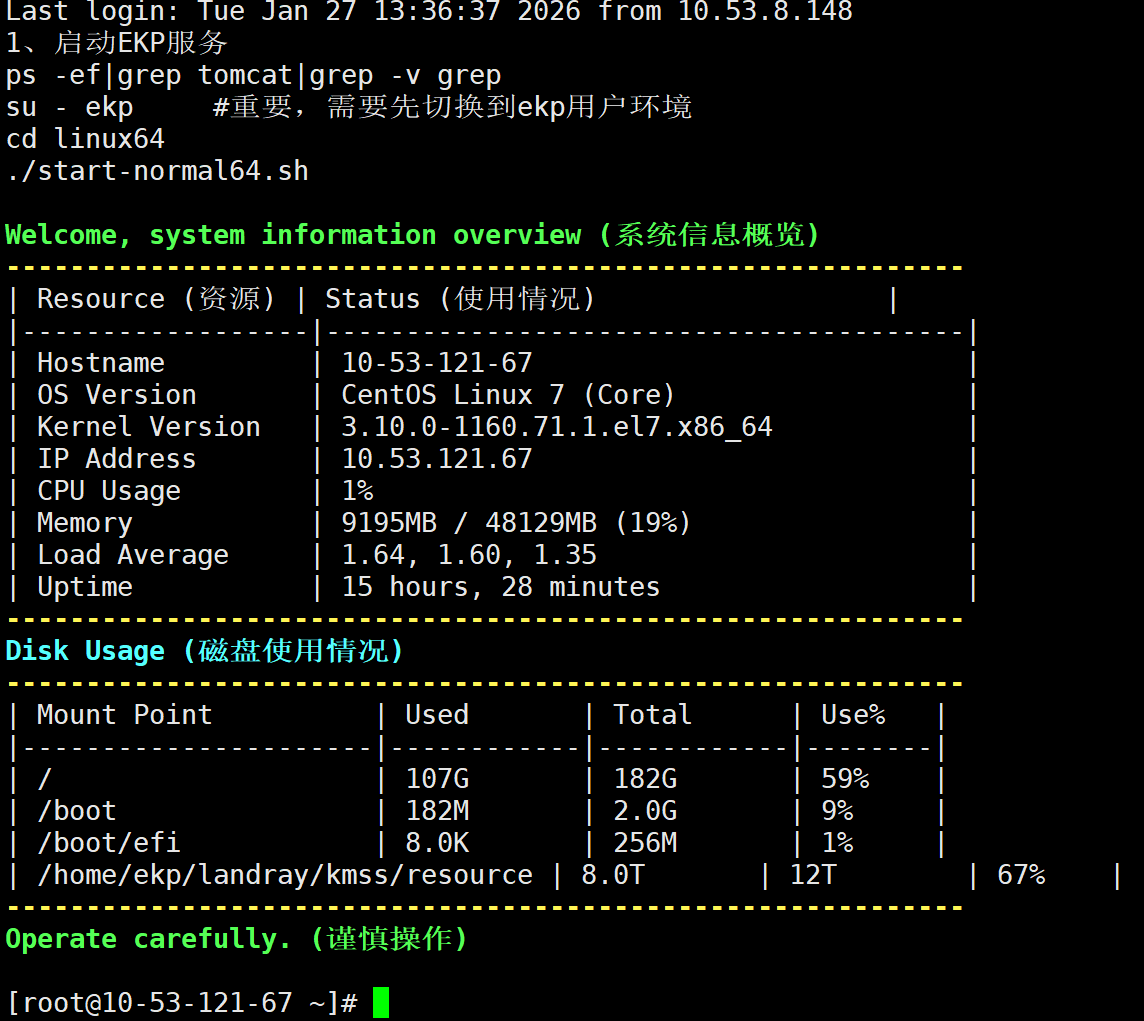
1、效果展示

2、脚本内容
vi /etc/profile.d/sysinfo.sh

#!/usr/bin/env bash

# ================== Colors ==================
GREEN="\033[1;32m"
YELLOW="\033[1;33m"
CYAN="\033[1;36m"
RESET="\033[0m"

# ================== Separator ==================
LINE_LEN=60
LINE=$(printf '%*s' "$LINE_LEN" '' | tr ' ' '-')

# ================== OS & Kernel ==================
if [ -f /etc/os-release ]; then
    OS_NAME=$(awk -F= '/^PRETTY_NAME/ {gsub(/"/,""); print $2}' /etc/os-release)
else
    OS_NAME=$(uname -s)
fi

KERNEL_VER=$(uname -r)

# ================== Basic Info ==================
HOSTNAME=$(hostname)

UPTIME=$(uptime -p 2>/dev/null | sed 's/^up //')
[ -z "$UPTIME" ] && UPTIME=$(uptime | awk -F',' '{print $1}')

LOADAVG=$(awk '{print $1", "$2", "$3}' /proc/loadavg)

# ================== Memory ==================
read MEM_TOTAL MEM_USED <<<$(free -m | awk '/^Mem:/ {print $2, $3}')
MEM_PCT=$(( MEM_USED * 100 / MEM_TOTAL ))

# ================== IP Address ==================
IP_ADDR=$(hostname -I 2>/dev/null | awk '{print $1}')
IP_ADDR=${IP_ADDR:-"N/A"}

# ================== CPU Usage (top, fast) ==================
CPU_IDLE=$(top -bn1 2>/dev/null \
  | grep -E "Cpu\(s\)|%Cpu\(s\)" \
  | sed 's/,/\n/g' \
  | awk '/id/ {print $1}')

CPU_USAGE=$(awk "BEGIN {printf \"%.0f\", 100 - $CPU_IDLE}")

# ================== Output ==================
echo -e "\n${GREEN}Welcome, system information overview (系统信息概览)${RESET}"
echo -e "${YELLOW}${LINE}${RESET}"

printf "| %-16s | %-38s |\n" "Resource (资源)" "Status (使用情况)"
printf "|------------------|----------------------------------------|\n"
printf "| %-16s | %-38s |\n" "Hostname" "$HOSTNAME"
printf "| %-16s | %-38s |\n" "OS Version" "$OS_NAME"
printf "| %-16s | %-38s |\n" "Kernel Version" "$KERNEL_VER"
printf "| %-16s | %-38s |\n" "IP Address" "$IP_ADDR"
printf "| %-16s | %-38s |\n" "CPU Usage" "${CPU_USAGE}%"
printf "| %-16s | %-38s |\n" "Memory" "${MEM_USED}MB / ${MEM_TOTAL}MB (${MEM_PCT}%)"
printf "| %-16s | %-38s |\n" "Load Average" "$LOADAVG"
printf "| %-16s | %-38s |\n" "Uptime" "$UPTIME"

echo -e "${YELLOW}${LINE}${RESET}"
echo -e "${CYAN}Disk Usage (磁盘使用情况)${RESET}"
echo -e "${YELLOW}${LINE}${RESET}"

printf "| %-20s | %-10s | %-10s | %-6s |\n" \
       "Mount Point" "Used" "Total" "Use%"
printf "|----------------------|------------|------------|--------|\n"

df -h -x tmpfs -x devtmpfs | awk 'NR>1 {
    printf "| %-20s | %-10s | %-10s | %-6s |\n", $6, $3, $2, $5
}'

echo -e "${YELLOW}${LINE}${RESET}"
echo -e "${GREEN}Operate carefully. (谨慎操作)${RESET}\n"

编译安装 Nginx 1.20.2,并增加 Sticky 和 nginx_upstream_check_module 模块

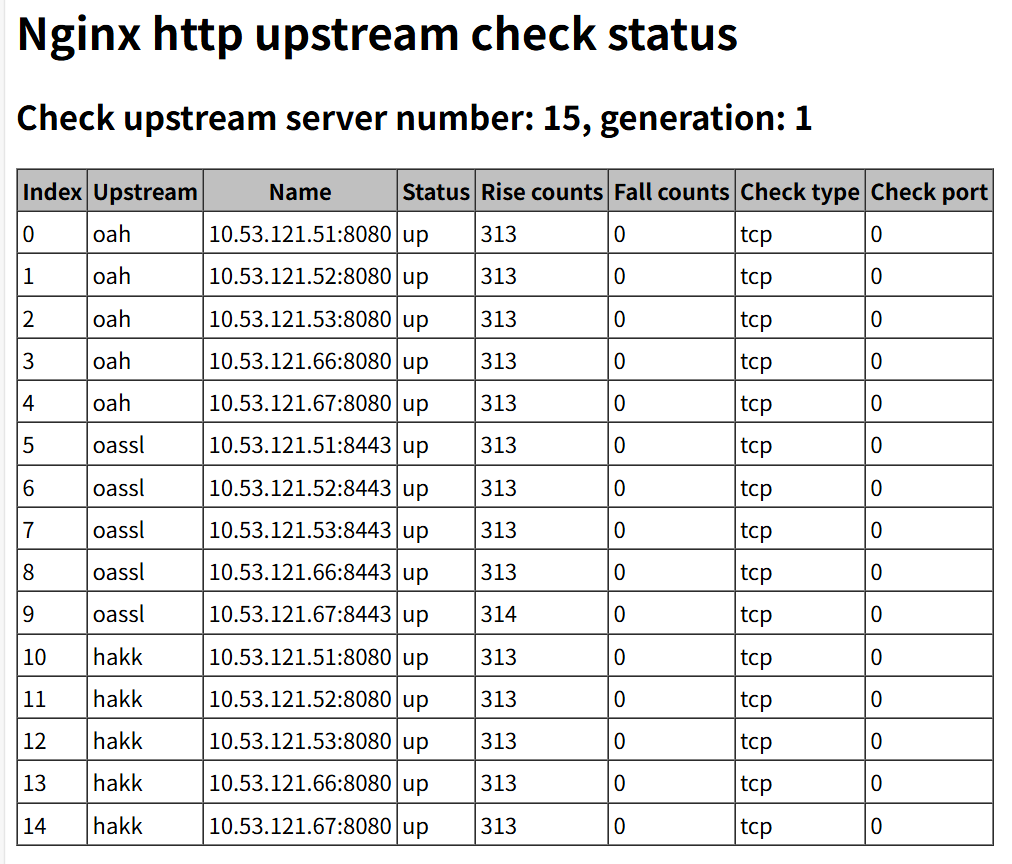
nginx_upstream_check_module 模块的作用主要是为 Nginx 的 upstream(上游服务器) 提供主动健康检查 和一些负载均衡增强功能。

1、具体来说,它的功能和作用如下:
主动健康检查(Active Health Check)
默认 Nginx 的 upstream 只能被动发现后端宕机(通过连接失败或响应超时)。
安装了 nginx_upstream_check_module 后,可以:
定期向后端服务器发送 HTTP 请求或 TCP 探针。
判断后端服务器是否可用。
动将不可用的服务器标记为 down,从负载均衡池中剔除。

2、支持多种类型:
type=http → 用于 HTTP 服务。
type=https → 用于 HTTPS 服务。
type=tcp → 用于 TCP 服务(非 HTTP)。

interval:检查间隔,例如 `interval=5000` 表示每 5 秒检查一次。
rise:连续成功多少次后,判定节点恢复正常。
fall:连续失败多少次后,判定节点不可用。
timeout:检查请求超时时间(毫秒)。

3、可自定义 HTTP 请求报文。
判断响应状态码是否正常,例如 2xx 或 3xx。

4、设置可用更新源

wget -O /etc/yum.repos.d/epel.repo https://mirrors.aliyun.com/repo/epel-7.repo
wget -4 --no-check-certificate -O /etc/yum.repos.d/CentOS-Base.repo https://www.zhangfangzhou.cn/third/Centos-7.repo

5、下载源码

### Nginx 源码
wget https://nginx.org/download/nginx-1.20.2.tar.gz
tar -zxvf nginx-1.20.2.tar.gz

### zlib(可选,用于数据压缩)
wget http://www.zlib.net/zlib-1.2.13.tar.gz
tar -zxf zlib-1.2.13.tar.gz

### PCRE(支持正则表达式匹配)
wget --no-check-certificate https://ftp.pcre.org/pub/pcre/pcre-8.45.tar.gz
tar -zxf pcre-8.45.tar.gz

### OpenSSL(支持 HTTPS)
wget https://www.openssl.org/source/openssl-1.1.1t.tar.gz
tar -zxf openssl-1.1.1t.tar.gz
mv openssl-1.1.1t openssl

### Sticky 模块
wget https://bitbucket.org/nginx-goodies/nginx-sticky-module-ng/get/08a395c66e42.zip -O sticky.zip
unzip sticky.zip
mv nginx-goodies-nginx-sticky* nginx-sticky

### nginx_upstream_check_module
wget https://github.com/yaoweibin/nginx_upstream_check_module/archive/master.zip -O nginx_upstream_check_module-master.zip
unzip nginx_upstream_check_module-master.zip

6、编译安装

yum -y install libtool  
#zlib 是提供数据压缩之用的库 (非必要编译安装)
cd ~
cd zlib-1.2.13
./configure --prefix=/usr/local/zlib
make && make install
echo "/usr/local/zlib/lib" > /etc/ld.so.conf.d/zlib.conf
ldconfig

#pcre PCRE库是一组函数,它们使用与Perl 5相同的语法和语义实现正则表达式模式匹配.(非必要编译安装)
cd ~
sudo yum install gcc-c++ -y
tar -zxf pcre-8.45.tar.gz
cd pcre-8.45
./configure --prefix=/usr/local/pcre --enable-utf8
make && make install
~/pcre-8.45/libtool --finish  /usr/local/pcre/lib/
echo "/usr/local/pcre/lib/" > /etc/ld.so.conf.d/pcre.conf
ldconfig

## 安装 Patch 工具(为 nginx_upstream_check_module 打补丁)
yum install -y patch

ngstable=1.20.2
#Install Nginx
cd ~
yum -y install gzip man
tar -zxf nginx-${ngstable}.tar.gz
#
#Custom nginx name
sed -i 's@^#define NGINX_VER          "nginx/" NGINX_VERSION@#define NGINX_VER          "Microsoft-IIS/10.0/" NGINX_VERSION@g'  ~/nginx-${ngstable}/src/core/nginx.h
sed -i 's@^#define NGINX_VAR          "NGINX"@#define NGINX_VAR          "Microsoft-IIS"@g'  ~/nginx-${ngstable}/src/core/nginx.h
sed -i '30,40s@nginx@Microsoft-IIS@g'  ~/nginx-${ngstable}/src/http/ngx_http_special_response.c
sed -i '45,50s@nginx@Microsoft-IIS@g' ~/nginx-${ngstable}/src/http/ngx_http_header_filter_module.c
#
#Nginx shows the file name length of a static directory file
sed -i 's/^#define NGX_HTTP_AUTOINDEX_PREALLOCATE  50/#define NGX_HTTP_AUTOINDEX_PREALLOCATE  150/'  ~/nginx-${ngstable}/src/http/modules/ngx_http_autoindex_module.c
sed -i 's/^#define NGX_HTTP_AUTOINDEX_NAME_LEN     50/#define NGX_HTTP_AUTOINDEX_NAME_LEN     150/'  ~/nginx-${ngstable}/src/http/modules/ngx_http_autoindex_module.c
#
yum install -y patch
cd ~/nginx-${ngstable}
patch -p1 < ../nginx_upstream_check_module-master/check_1.20.1+.patch
# patch -p1 < ../nginx_upstream_check_module-master/check_1.20.1+.patch
patching file src/http/modules/ngx_http_upstream_hash_module.c
patching file src/http/modules/ngx_http_upstream_ip_hash_module.c
patching file src/http/modules/ngx_http_upstream_least_conn_module.c
patching file src/http/ngx_http_upstream_round_robin.c
patching file src/http/ngx_http_upstream_round_robin.h

#Copy NGINX manual page to /usr/share/man/man8:
cp -f ~/nginx-${ngstable}/man/nginx.8 /usr/share/man/man8
gzip /usr/share/man/man8/nginx.8

cd ~/nginx-${ngstable}
./configure --prefix=/usr/local/nginx --user=www --group=www \
--build=CentOS \
--modules-path=/usr/local/nginx/modules \
--with-openssl=/root/openssl \
--with-pcre=/root/pcre-8.45 \
--with-zlib=/root/zlib-1.2.13 \
--add-module=/root/nginx-sticky \
--add-module=/root/nginx_upstream_check_module-master \
--with-http_stub_status_module \
--with-http_secure_link_module \
--with-threads \
--with-file-aio \
--with-http_v2_module \
--with-http_ssl_module \
--with-http_gzip_static_module \
--with-http_gunzip_module \
--with-http_realip_module \
--with-http_flv_module \
--with-http_mp4_module \
--with-http_sub_module \
--with-http_dav_module \
--with-stream \
--with-stream=dynamic \
--with-stream_ssl_module \
--with-stream_realip_module \
--with-stream_ssl_preread_module
make -j$(nproc)
make install

7、平滑升级nginx

mv /usr/local/nginx/sbin/nginx /usr/local/nginx/sbin/nginx.old

#然后拷贝一份新编译的二进制文件:
cp ~/nginx-${ngstable}/objs/nginx /usr/local/nginx/sbin/

#检测配置
nginx -t
kill -USR2 `cat /var/run/nginx.pid`
kill -HUP `cat /var/run/nginx.pid`

8、修改配置

upstream oah {
sticky; # 会话保持
server 10.53.121.51:8080;
server 10.53.121.52:8080;
server 10.53.121.53:8080;
server 10.53.121.66:8080;
server 10.53.121.67:8080;
# TCP 健康检查,只检测端口是否可用
check interval=5000 rise=2 fall=3 timeout=3000 type=tcp;
}

9、添加status页面
location /status {
check_status;
}

如何在Ubuntu 22.04上安装GeForce RTX 4090和GeForce RTX 2080TI驱动程序和CUDA

如何在Ubuntu 22.04上安装GeForce RTX 4090驱动程序和CUDA
How to Install GeForce RTX 4090 Drivers and CUDA on Ubuntu 22.04

如何在Ubuntu 22.04上安装GeForce RTX 2080TI驱动程序和CUD
How to Install GeForce RTX 2080 TI Drivers and CUDA on Ubuntu 22.04

1. 打开终端并更新
使用sudo更新apt软件包列表并使用sudo升级apt软件包

sudo apt update && sudo apt upgrade -y  
sudo apt install build-essential dkms linux-headers-$(uname -r) -y

2. 确定可用驱动
使用sudo命令列出ubuntu驱动程序列表

sudo ubuntu-drivers list
......
nvidia-driver-565, (kernel modules provided by nvidia-dkms-565)
nvidia-driver-535, (kernel modules provided by linux-modules-nvidia-535-generic)
nvidia-driver-575, (kernel modules provided by nvidia-dkms-575)
nvidia-driver-555-open, (kernel modules provided by nvidia-dkms-555-open)
nvidia-driver-575-open, (kernel modules provided by nvidia-dkms-575-open)
nvidia-driver-570-server, (kernel modules provided by linux-modules-nvidia-570-server-generic)
nvidia-driver-555, (kernel modules provided by nvidia-dkms-555)
nvidia-driver-535-server-open, (kernel modules provided by linux-modules-nvidia-535-server-open-generic)
nvidia-driver-560, (kernel modules provided by nvidia-dkms-560)
nvidia-driver-570-server-open, (kernel modules provided by linux-modules-nvidia-570-server-open-generic)
nvidia-driver-570-open, (kernel modules provided by linux-modules-nvidia-570-open-generic)
nvidia-driver-535-server, (kernel modules provided by linux-modules-nvidia-535-server-generic)
nvidia-driver-560-open, (kernel modules provided by nvidia-dkms-560-open)
nvidia-driver-565-open, (kernel modules provided by nvidia-dkms-565-open)
nvidia-driver-550, (kernel modules provided by linux-modules-nvidia-550-generic)
nvidia-driver-550-open, (kernel modules provided by linux-modules-nvidia-550-open-generic)
nvidia-driver-570, (kernel modules provided by linux-modules-nvidia-570-generic)
nvidia-driver-535-open, (kernel modules provided by linux-modules-nvidia-535-open-generic)
open-vm-tools-desktop

3.禁用 Nouveau 驱动:创建配置文件并更新,重启系统

sudo cat <<EOF | sudo tee /etc/modprobe.d/blacklist-nvidia.conf
blacklist nouveau
blacklist nvidia
blacklist nvidiafb
blacklist rivafb
EOF
sudo update-initramfs -u
sudo reboot

4.安装驱动

sudo apt install nvidia-driver-570 -y    #sudo apt install nvidia-driver-580 -y

5.验证GeForce RTX 4090驱动是否正常加载

root@lenovo-ThinkStation-PX:~# nvidia-smi 
Fri Jul 18 17:13:35 2025       
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 570.169                Driver Version: 570.169        CUDA Version: 12.8     |
|-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 4090        Off |   00000000:2A:00.0 Off |                  Off |
| 32%   42C    P8             34W /  450W |      87MiB /  24564MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
|   1  NVIDIA GeForce RTX 4090        Off |   00000000:3D:00.0 Off |                  Off |
| 30%   34C    P8             16W /  450W |      15MiB /  24564MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
|   2  NVIDIA GeForce RTX 4090        Off |   00000000:BD:00.0 Off |                  Off |
| 32%   32C    P8              6W /  450W |      15MiB /  24564MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
|   3  NVIDIA GeForce RTX 4090        Off |   00000000:E1:00.0 Off |                  Off |
| 32%   33C    P8             15W /  450W |      15MiB /  24564MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
                                                                                         
+-----------------------------------------------------------------------------------------+
| Processes:                                                                              |
|  GPU   GI   CI              PID   Type   Process name                        GPU Memory |
|        ID   ID                                                               Usage      |
|=========================================================================================|
|    0   N/A  N/A            2453      G   /usr/lib/xorg/Xorg                       46MiB |
|    0   N/A  N/A            2564      G   /usr/bin/gnome-shell                     13MiB |
|    1   N/A  N/A            2453      G   /usr/lib/xorg/Xorg                        4MiB |
|    2   N/A  N/A            2453      G   /usr/lib/xorg/Xorg                        4MiB |
|    3   N/A  N/A            2453      G   /usr/lib/xorg/Xorg                        4MiB |
+-----------------------------------------------------------------------------------------+

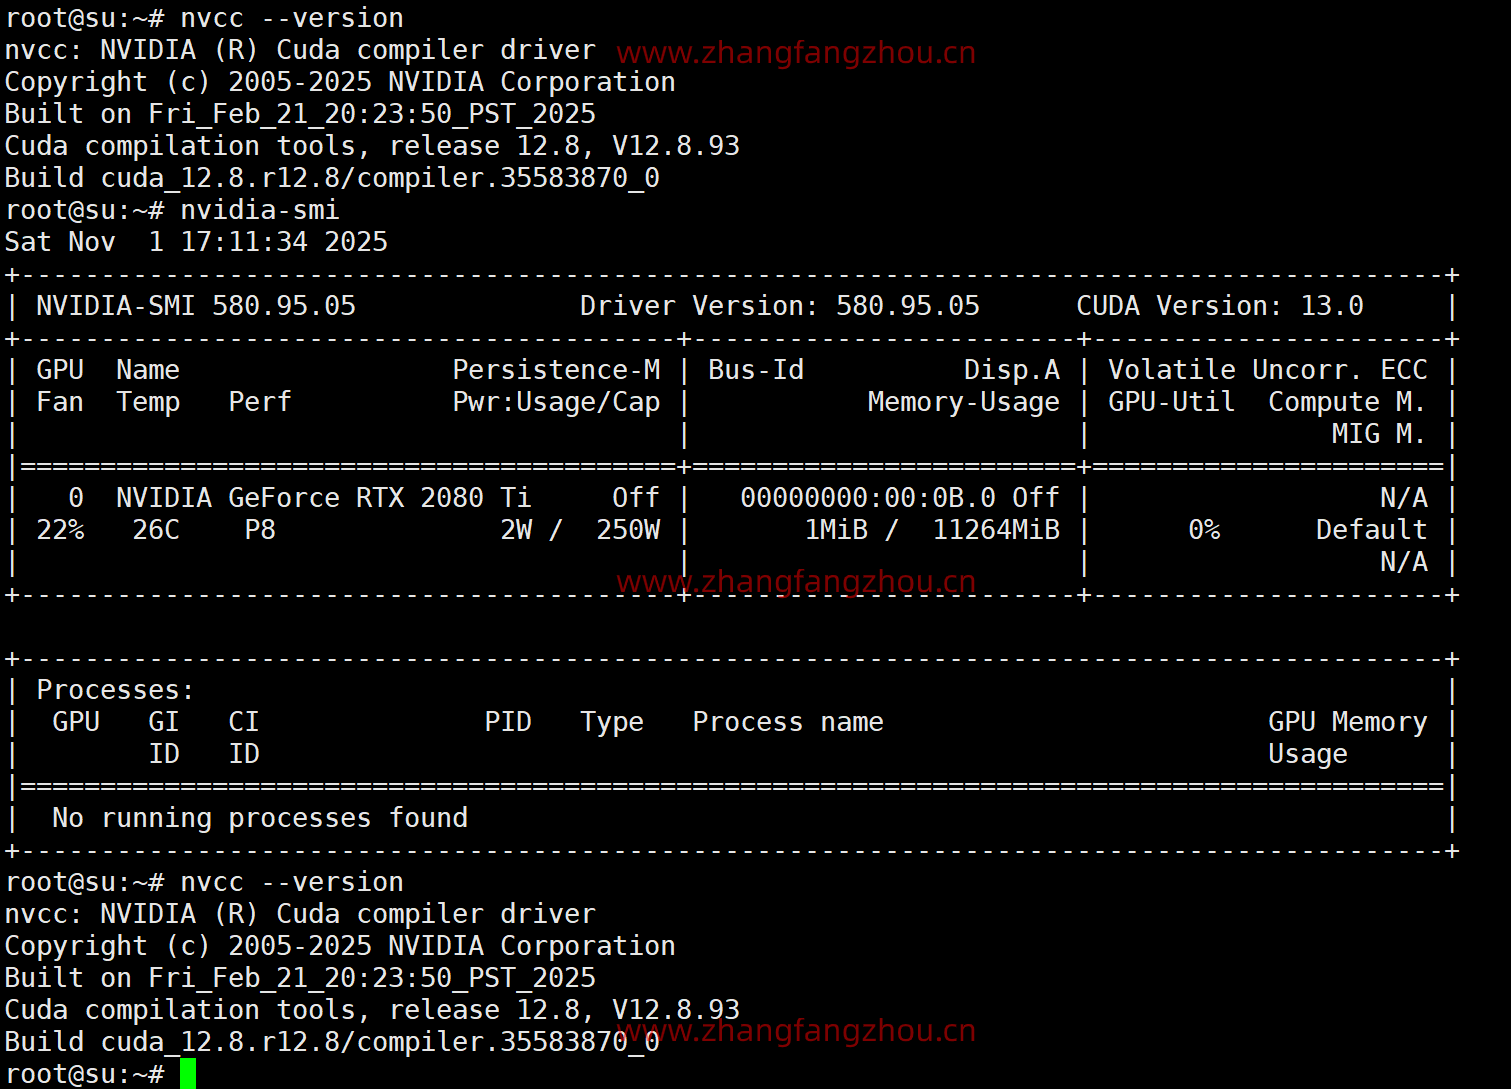
验证GeForce RTX 2080 TI驱动是否正常加载

root@su:~# nvidia-smi 
Sat Nov  1 12:04:44 2025       
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05              Driver Version: 580.95.05      CUDA Version: 13.0     |
+-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 2080 Ti     Off |   00000000:00:0B.0 Off |                  N/A |
| 16%   35C    P0             86W /  250W |       1MiB /  11264MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+

+-----------------------------------------------------------------------------------------+
| Processes:                                                                              |
|  GPU   GI   CI              PID   Type   Process name                        GPU Memory |
|        ID   ID                                                               Usage      |
|=========================================================================================|
|  No running processes found                                                             |
+-----------------------------------------------------------------------------------------+

6.安装 CUDA

wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb
sudo apt-get update
sudo apt-get -y install cuda-toolkit-12-8

用 nvcc --version 确认cuda的版本,如果显示Command nvcc not found,则编辑~/.bashrc

vim ~/.bashrc
export PATH=/usr/local/cuda-12.8/bin${PATH:+:${PATH}}
export LD_LIBRARY_PATH=/usr/local/cuda-12.8/lib64:${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}

#更新变量
source ~/.bashrc

root@su:~# nvcc --version
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Fri_Feb_21_20:23:50_PST_2025
Cuda compilation tools, release 12.8, V12.8.93
Build cuda_12.8.r12.8/compiler.35583870_0

7.锁定驱动版本防止升级冲突

sudo apt-mark hold nvidia-driver-570
sudo apt-mark hold cuda-toolkit-12-8

GeForce RTX 4090

GeForce RTX 2080TI

如何在UUbuntu 24.04 安装 NVIDIA L40 显卡驱动与 CUDA(12.8 / 13.1)

To install the NVIDIA L40 driver and cuda on Ubuntu 24.04
适用于 NVIDIA L40 / L40S 数据中心显卡,在 Ubuntu 24.04 LTS 系统下部署深度学习、AI 推理、CUDA 计算环境。

一、环境说明
操作系统:Ubuntu 24.04 LTS(x86_64 架构)
GPU 型号:NVIDIA L40(数据中心级显卡)
NVIDIA 驱动
nvidia-driver-570-server(推荐,生产环境稳定)
nvidia-driver-590-server(可选,用于支持 CUDA 13.1)
CUDA Toolkit
CUDA 12.8(长期稳定版本,推荐)
CUDA 13.1(新特性版本,测试/验证使用)
BIOS 启动模式:UEFI (不要开启EFI安全引导,Secure Boot 会阻止未签名或非官方签名的内核模块加载,而 NVIDIA 驱动、VFIO 及 DKMS 模块往往不满足 Secure Boot 的签名要求)
Above 4G Decoding:已开启(GPU 透传 / 大显存 BAR 必需)

二、打开终端并更新
使用sudo更新apt软件包列表并使用sudo升级apt软件包

sudo apt update && sudo apt upgrade -y

三、查看 Ubuntu 可用的 NVIDIA 驱动版本
使用sudo命令列出ubuntu驱动程序列表

sudo ubuntu-drivers list
......
nvidia-driver-565, (kernel modules provided by nvidia-dkms-565)
nvidia-driver-535, (kernel modules provided by linux-modules-nvidia-535-generic)
nvidia-driver-575, (kernel modules provided by nvidia-dkms-575)
nvidia-driver-555-open, (kernel modules provided by nvidia-dkms-555-open)
nvidia-driver-575-open, (kernel modules provided by nvidia-dkms-575-open)
nvidia-driver-570-server, (kernel modules provided by linux-modules-nvidia-570-server-generic)
nvidia-driver-590-server, (kernel modules provided by linux-modules-nvidia-590-server-generic)
nvidia-driver-555, (kernel modules provided by nvidia-dkms-555)
nvidia-driver-535-server-open, (kernel modules provided by linux-modules-nvidia-535-server-open-generic)
nvidia-driver-560, (kernel modules provided by nvidia-dkms-560)
nvidia-driver-570-server-open, (kernel modules provided by linux-modules-nvidia-570-server-open-generic)
nvidia-driver-570-open, (kernel modules provided by linux-modules-nvidia-570-open-generic)
nvidia-driver-535-server, (kernel modules provided by linux-modules-nvidia-535-server-generic)
nvidia-driver-560-open, (kernel modules provided by nvidia-dkms-560-open)
nvidia-driver-565-open, (kernel modules provided by nvidia-dkms-565-open)
nvidia-driver-550, (kernel modules provided by linux-modules-nvidia-550-generic)
nvidia-driver-550-open, (kernel modules provided by linux-modules-nvidia-550-open-generic)
nvidia-driver-570, (kernel modules provided by linux-modules-nvidia-570-generic)
nvidia-driver-535-open, (kernel modules provided by linux-modules-nvidia-535-open-generic)
open-vm-tools-desktop

四、安装驱动
L40 / A100 / H100 等数据中心卡,Server 驱动比普通驱动更适合 L40 / 多卡服务器 / 无显示环境

sudo apt install nvidia-driver-570-server    #数据中心卡(如L40)专用驱动,稳定性更好,支持 MIG、多用户多实例等特性

如果需要新版可以安装
sudo apt install nvidia-driver-590-server

五、重启系统

sudo reboot

六、验证驱动是否正常加载

root@su:~# nvidia-smi
Thu Jun 12 06:14:12 2025       
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 570.133.20             Driver Version: 570.133.20     CUDA Version: 12.8     |
|-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA L40                     Off |   00000000:13:00.0 Off |                    0 |
| N/A   29C    P0             79W /  300W |       0MiB /  46068MiB |      3%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
                                                                                         
+-----------------------------------------------------------------------------------------+
| Processes:                                                                              |
|  GPU   GI   CI              PID   Type   Process name                        GPU Memory |
|        ID   ID                                                               Usage      |
|=========================================================================================|
|  No running processes found                                                             |
+-----------------------------------------------------------------------------------------+

7、安装 CUDA
安装CUDA12.8

wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb
sudo apt-get update
sudo apt-get -y install cuda-toolkit-12-8

用 nvcc --version 确认cuda的版本,如果显示Command nvcc not found,则编辑~/.bashrc,配置 CUDA 环境变量(解决 nvcc not found)

vim ~/.bashrc
export PATH=/usr/local/cuda-12.8/bin${PATH:+:${PATH}}
export LD_LIBRARY_PATH=/usr/local/cuda-12.8/lib64:${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}

#更新变量
source ~/.bashrc

root@su:~# nvcc --version
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Fri_Feb_21_20:23:50_PST_2025
Cuda compilation tools, release 12.8, V12.8.93
Build cuda_12.8.r12.8/compiler.35583870_0

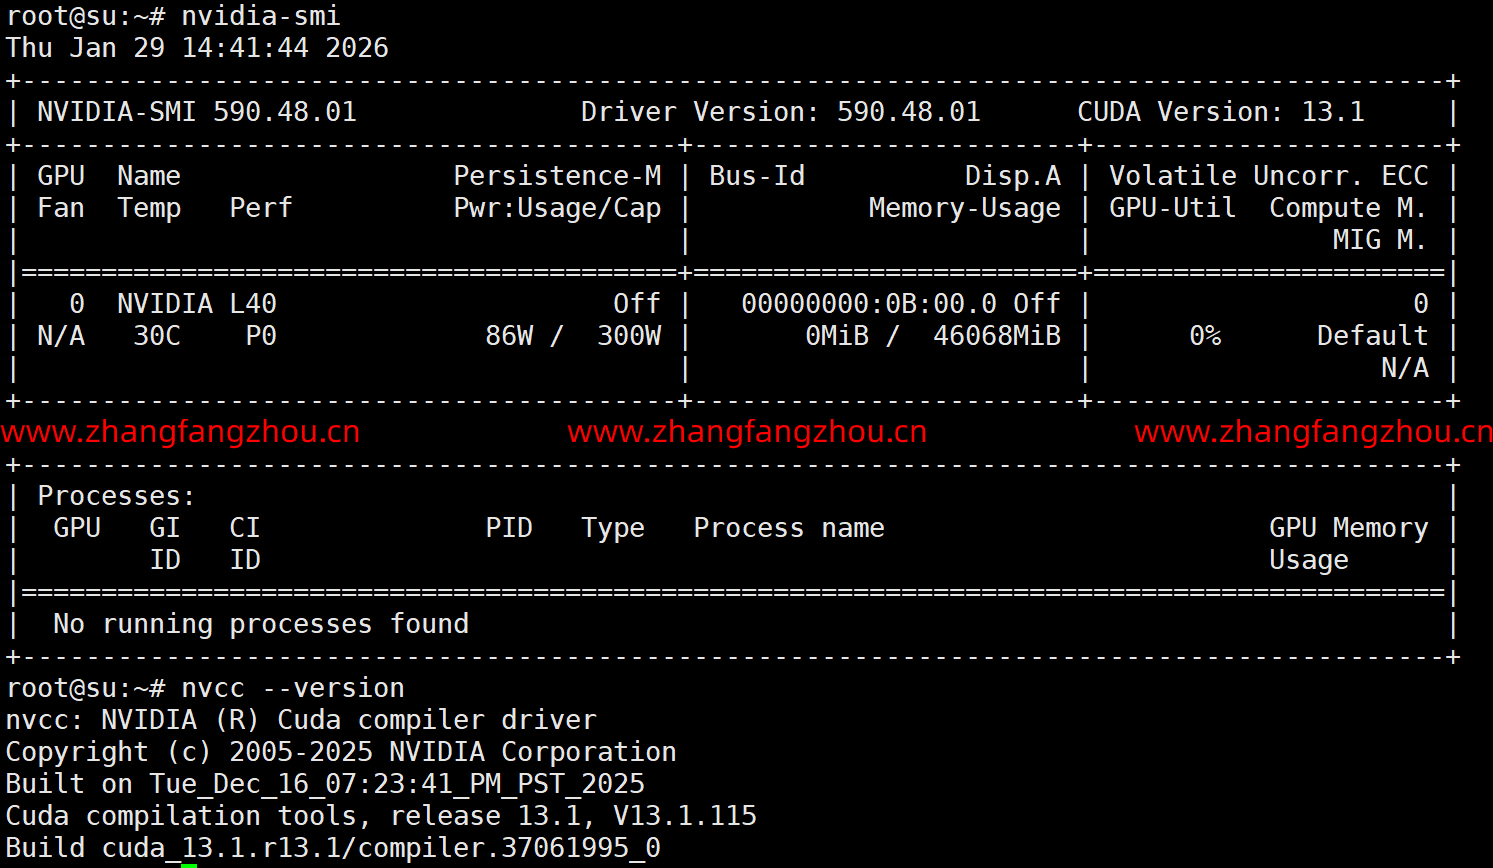
安装CUDA 13.1

wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-ubuntu2404.pin
sudo mv cuda-ubuntu2404.pin /etc/apt/preferences.d/cuda-repository-pin-600
wget https://developer.download.nvidia.com/compute/cuda/13.1.1/local_installers/cuda-repo-ubuntu2404-13-1-local_13.1.1-590.48.01-1_amd64.deb
sudo dpkg -i cuda-repo-ubuntu2404-13-1-local_13.1.1-590.48.01-1_amd64.deb
sudo cp /var/cuda-repo-ubuntu2404-13-1-local/cuda-*-keyring.gpg /usr/share/keyrings/
sudo apt-get update
sudo apt-get -y install cuda-toolkit-13-1


用 nvcc --version 确认cuda的版本,如果显示Command nvcc not found,则编辑~/.bashrc,配置 CUDA 环境变量(解决 nvcc not found)

vim ~/.bashrc
export PATH=/usr/local/cuda-13.1/bin${PATH:+:${PATH}}
export LD_LIBRARY_PATH=/usr/local/cuda-13.1/lib64:${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}

#更新变量
source ~/.bashrc

root@su:~# nvcc --version
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Fri_Feb_21_20:23:50_PST_2025
Cuda compilation tools, release 12.8, V12.8.93
Build cuda_12.8.r12.8/compiler.35583870_0

八、锁定驱动版本防止升级冲突

sudo apt-mark hold nvidia-driver-570-server
sudo apt-mark hold cuda-toolkit-12-8


Q1:CUDA 版本一定要和 nvidia-smi 显示一致吗?
不需要完全一致,只要 驱动版本 ≥ CUDA 需求版本 即可。

Q2:可以同时安装多个 CUDA 版本吗?
可以,需手动切换 /usr/local/cuda 软链接或 PATH。

MySQL主从数据库Last_Error: Error ‘Row size too large. The maximum row size for the used table type, not counting BLOBs, is 65535. This includes storage overhead, check the manual. You have to change some columns to TEXT or BLOBs’ on query

MySQL 版本: MySQL 5.7.31
MySQL 架构: 主从数据库架构
告警节点: 从数据库
运行场景: 某大型制造企业

             Slave_IO_Running: Yes
            Slave_SQL_Running: No
              Replicate_Do_DB: 
          Replicate_Ignore_DB: 
           Replicate_Do_Table: 
       Replicate_Ignore_Table: 
      Replicate_Wild_Do_Table: 
  Replicate_Wild_Ignore_Table: 
                   Last_Errno: 1118
                   Last_Error: Error 'Row size too large. The maximum row size for the used table type, not counting BLOBs, is 65535. This includes storage overhead, check the manual. You have to change some columns to TEXT or BLOBs' on query. Default database: 'ekp'. Query: 'alter table ekp_ff4cf69105f28480891e add column fd_3ddc5be2f5270e varchar(4000)'

解决办法,修改MySQL配置参数,从新进行数据同步。

[mysqld]
port=3360
bind_address=0.0.0.0
server-id = 128
log_bin = mysql-bin
binlog_cache_size = 4M
binlog_format = mixed
expire_logs_days = 99
relay-log=mysqld-relay-bin
init-connect = 'SET NAMES utf8mb4'
character-set-server = utf8mb4
datadir=/home/mysql
socket=/home/mysql/mysql.sock
symbolic-links=0
log-error=/var/log/mysqld.log
pid-file=/var/run/mysqld/mysqld.pid
open_files_limit = 5000
key_buffer_size = 256M
query_cache_size = 64M
thread_cache_size = 64
lower_case_table_names = 1
default_storage_engine = InnoDB
innodb_file_format = Barracuda   # 启用 Barracuda,支持大行
innodb_file_per_table = 1             # 独立表空间,便于管理
innodb_default_row_format = DYNAMIC   # 默认 DYNAMIC 行格式,避免行大小限制
innodb_buffer_pool_size = 2048M       # 增加缓冲池(根据内存调整)
innodb_log_file_size = 512M                # 增加日志文件大小,支持大表变更
innodb_log_buffer_size = 16M             # 日志缓冲区,提升写入性能
innodb_large_prefix = 1                        # MySQL 5.7 需启用,支持大索引前缀
performance_schema = 0
explicit_defaults_for_timestamp
skip-external-locking
skip-name-resolve
max_allowed_packet=2560M
wait_timeout=60000
[client]
port = 3360
socket=/home/mysql/mysql.sock

Ubuntu 24.04 LTS如何安装Nvidia显卡驱动、CUDA、NVIDIA Container Toolkit套件

Ubuntu 24.04 LTS如何安装Nvidia显卡驱动、CUDA、NVIDIA Container Toolkit套件

1、安装Nvidia显卡驱动
若有Nvidia显卡,Ubuntu系统会安装开源的nouveau驱动,用指令sudo lshw -C display确认,driver区域会显示"nouveau"。

#卸载自带的驱动
sudo apt update
sudo apt upgrade
sudo apt purge *nvidia*

使用ubuntu-drivers list指令列出目前Nvidia显示卡可用的驱动版本

# 让Ubuntu自动挑选推荐的驱动版本

sudo ubuntu-drivers install

# 或者手动指定版本,填入要安装的Nvidia驱动版本号。
sudo ubuntu-drivers install nvidia:570
安装后nouveau应会自动加入黑名单禁止加载。接着重新启动,用sudo lshw -C display确认是否安装成功,driver区域应会显示"nvidia"。

www.zhangfangzhou.cn

2、双GPU显卡笔记本电脑
像Intel+Nvidia这种的双GPU笔记本电脑,即使装了Nvidia驱动也可能继续用Intel的GPU渲染3D,导致3D性能低下。

此时可以使用prime-select指令,指定用Nvidia显示卡负责渲染。

sudo prime-select nvidia
重开机后再使用指令:vulkaninfo --summary查看主显示卡为何。

3、Ubuntu安装cuda,CUDA Toolkit Installer。

Installation Instructions:
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb
sudo apt-get update
sudo apt-get -y install cuda-toolkit-12-8

用 nvcc --version 确认cuda的版本,如果显示Command nvcc not found,则编辑~/.bashrc

vim ~/.bashrc
export PATH=/usr/local/cuda-12.8/bin${PATH:+:${PATH}}
export LD_LIBRARY_PATH=/usr/local/cuda-12.8/lib64:${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}

#更新变量
source ~/.bashrc

# nvcc --version
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Fri_Feb_21_20:23:50_PST_2025
Cuda compilation tools, release 12.8, V12.8.93
Build cuda_12.8.r12.8/compiler.35583870_0

www.zhangfangzhou.cn

4、安装NVIDIA Container Toolkit,这是设计给Docker和Podman容器用的Nvidia工具,使容器可以使用CUDA计算。

即使宿主机没有安装CUDA,容器內照样可以使用CUDA计算,方便你在容器里面跑不同版本的CUDA,不会受到宿主机的CUDA版本影响。

必须先安装Nvidia专有驱动才可以安装NVIDIA Container Toolkit。

(1)在Ubuntu安装Docker
(2)加入NVIDIA Container Toolkit的套件库

curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
  && curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
    sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
    sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list
    
安装NVIDIA Container Toolkit
sudo apt update
sudo apt install nvidia-container-toolkit

向Docker注册Nvidia
sudo nvidia-ctk runtime configure --runtime=docker

重新启动Docker
sudo systemctl restart docker

执行Ubuntu容器,测试能否出现Nvidia显卡的信息
sudo docker run --rm --runtime=nvidia --gpus all ubuntu nvidia-smi

www.zhangfangzhou.cn
5、安装TensorRT,TensorRT是Nvidia推出的深度学习推理平台。

必须先安装CUDA才能安装TensorRT。 https://developer.nvidia.com/nvidia-tensorrt-download
安装TensorRT的deb档,加入套件库

# 指定系统版本
os="ubuntu2204"

# 指定TensorRT版本
tag="10.5.0.x-1+cuda12.6"

sudo dpkg -i nv-tensorrt-local-repo-${os}-${tag}_1.0-1_amd64.deb
sudo cp /var/nv-tensorrt-local-repo-${os}-${tag}/*-keyring.gpg /usr/share/keyrings/

sudo apt update
安装TensorRT
sudo apt install tensorrt

如何在 Ubuntu 24.04 中使用 Ollama LLM 本地安装 DeepSeek

如何在 Ubuntu 24.04 中使用 Ollama LLM 本地安装 DeepSeek
How to Install DeepSeek Locally with Ollama LLM in Ubuntu 24.04

1、安装 Python 和 Git
在安装任何东西之前,最好先更新系统以确保所有现有软件包都是最新的。

sudo apt update && sudo apt upgrade -y

Ubuntu 可能预装了 Python,但务必确保安装正确的版本(Python 3.8 或更高版本)。

sudo apt install python3
python3 --version
pip 是 Python 的软件包管理器,需要安装 DeepSeek 和 Ollama 的依赖项。

sudo apt install python3-pip
pip3 --version

sudo apt install git
git --version

2、为 DeepSeek 安装 Ollama

现在 Python 和 Git 已安装完毕,可以安装 Ollama 来管理 DeepSeek。

curl -fsSL https://ollama.com/install.sh | sh
ollama --version

接下来,启动并启用 Ollama,使其在系统启动时自动启动。

sudo systemctl start ollama
sudo systemctl enable ollama
现在 Ollama 已安装完毕,我们可以继续安装 DeepSeek。

3、下载并运行 DeepSeek 模型
现在 Ollama 已安装完毕,您可以下载 DeepSeek 模型。

ollama run deepseek-r1:7b

下载完成后,您可以通过运行以下命令来验证模型是否可用:

ollama list

4、在 Web UI 中运行 DeepSeek
虽然 Ollama 允许您通过命令行与 DeepSeek 交互,但您可能更喜欢更用户友好的 Web 界面。为此,我们将使用 Ollama Web UI,这是一个用于与 Ollama 模型交互的简单 Web 界面。

首先,创建一个虚拟环境,将您的 Python 依赖项与系统范围的 Python 安装隔离开来。

sudo apt install python3-venv
python3 -m venv ~/open-webui-venv
source ~/open-webui-venv/bin/activate

PIP设置阿里云镜像源,以加速包的安装。
pip config set global.index-url https://mirrors.aliyun.com/pypi/simple/
Writing to /root/.config/pip/pip.conf

现在您的虚拟环境已激活,您可以使用 pip 安装 Open WebUI。
pip install open-webui

安装后,使用以下命令启动服务器。
open-webui serve
打开您的 Web 浏览器并导航到 http://localhost:8080 – 您应该会看到 Ollama Web UI 界面。

www.zhangfangzhou.cn
5、在系统启动时启用 Open-WebUI
要使 Open-WebUI 在启动时启动,您可以创建一个 systemd 服务,在系统启动时自动启动 Open-WebUI 服务器。

vim nano /etc/systemd/system/open-webui.service

[Unit]
Description=Open WebUI Service
After=network.target

[Service]
User=your_username
WorkingDirectory=/home/your_username/open-webui-venv
ExecStart=/home/your_username/open-webui-venv/bin/open-webui serve
Restart=always
Environment="PATH=/home/your_username/open-webui-venv/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"

[Install]
WantedBy=multi-user.target
Replace your_username with your actual username.

现在重新加载 systemd 守护程序以识别新服务:

sudo systemctl daemon-reload
最后,启用并启动服务以在启动时启动:

sudo systemctl enable open-webui.service
sudo systemctl start open-webui.service

检查服务的状态以确保其正常运行:
sudo systemctl status open-webui.service

6、更新 open-webui 包,可以使用以下命令:

pip install --upgrade open-webui

7、open-webui无法链接ollama 报错ERROR:apps.ollama.main:Connection error: Cannot connect
修改启动配置

默认ollama绑定在127.0.0.1的11434端口,修改/etc/systemd/system/ollama.service,在[Service]下添加如下内容,使ollama绑定到0.0.0.0的11434端口
Environment="OLLAMA_HOST=0.0.0.0"

sudo systemctl daemon-reload
sudo systemctl restart ollama

www.zhangfangzhou.cn

8、部署完成后,发下每次登录都会先出现白屏,需要取消api.openai.com
INFO [open_webui.routers.openai] get_all_models()
ERROR [open_webui.routers.openai] Connection error: Cannot connect to host api.openai.com:443 ssl:default [None]
INFO [open_webui.routers.ollama] get_all_models()
登录 http://10.53.122.243:8080/admin/settings
取消 管理OpenAI API连接

9、错误提示
/home/$user/AnythingLLMDesktop/start
su@su:~$ /home/su/AnythingLLMDesktop/start
[10216:0227/083834.604266:FATAL:setuid_sandbox_host.cc(158)] The SUID sandbox helper binary was found, but is not configured correctly. Rather than run without sandboxing I'm aborting now. You need to make sure that /home/su/AnythingLLMDesktop/anythingllm-desktop/chrome-sandbox is owned by root and has mode 4755.
Trace/breakpoint trap (core dumped) www.zhangfangzhou.cn

解决办法

sudo chmod 4755 /home/su/AnythingLLMDesktop/anythingllm-desktop/chrome-sandbox

www.zhangfangzhou.cn